혼자서 6족 로봇에게 걷는 법을 가르쳤다
다리 여섯 개 달린 금색 로봇이 있다. 걷는 법은 아무도 가르쳐 주지 않았다. 넘어지고 또 넘어지면서 스스로 익혔다. 지금은 브라우저 안에서 실시간 물리로 돌아가고, 쇠공을 던지면 휘청하다가 다시 걸어간다. 이 녀석을 만든 이야기를 적어 본다.
데모는 여기 있다. 설치할 것 없이 브라우저에서 바로 열린다.
https://www.coolspeed.org/gold-spider/
이게 뭐냐면
금거미(Gold Spider)라고 이름 붙였다. 다리가 여섯 개고 몸통이 금색이라서 그렇다.
이 로봇의 걸음은 내가 한 프레임도 그리지 않았다. 신경망이 강화학습으로 알아서 익힌 것이다. 데모 페이지를 열면 MuJoCo 물리 엔진이 1초에 480번 몸을 계산하고, 그 사이 신경망이 1초에 30번씩 관절 24개를 어느 각도로 둘지 정한다. 서버는 정적 파일만 내려줄 뿐이고, 계산은 전부 보는 사람의 브라우저에서 돈다.
블록이 들쭉날쭉 쌓인 지형 위를 걷는 중에 171kg짜리 쇠공이나 79kg짜리 나무 상자를 던질 수 있다. 맞으면 휘청하고, 다리로 버티고, 원래 가던 쪽으로 다시 걸어간다. 이 반응도 내가 만든 게 아니다. 물리와 학습이 만든 거라서, 같은 공을 같은 자리에 던져도 매번 조금씩 다르게 받아낸다.
왜 만들었나
계기는 Embark Studios다. Embark는 2021년에 물리 시뮬레이션 속 로봇이 강화학습으로 걷는 법을 배우는 영상을 공개했고, 올해 NDC에서는 ARC Raiders의 로봇을 만들면서 몇 년 동안 겪은 시행착오를 꽤 솔직하게 풀었다. 보는 내내 같은 생각이 들었다. 이거, 혼자서도 될까?
나는 혼자 일하고, 옆에 애니메이터가 있는 것도 아니다. 캐릭터가 맞고, 미끄러지고, 다시 중심을 잡는 모습을 매번 다르게 보여 주려면 손으로 키프레임을 찍는 방식은 금방 벽에 부딪힌다. 공개된 이야기만 가지고 한 사람이 어디까지 갈 수 있는지 직접 확인해 보고 싶었다.
미리 밝혀 두자면 Embark와는 아무 관계가 없다. Embark의 코드나 데이터를 쓴 적도 없고, 공개된 글과 발표에서 얻은 아이디어만 참고했다.
신경망은 애니메이터가 아니라 운전수다
구조 자체는 Embark가 발표에서 설명한 것과 크게 다르지 않다. 게임은 "이쪽으로, 이 속도로 가"라는 목표만 준다. 신경망은 지금 몸이 어떤 자세인지, 발밑 지형이 어떻게 생겼는지를 보고 관절마다 목표 각도를 정한다. 그러면 관절마다 붙은 모터가 그 각도로 가려고 힘을 쓰고, 몸이 실제로 어떻게 움직일지는 물리 엔진이 정한다. 신경망은 바뀐 몸을 다시 보고 다음 각도를 정한다. 이게 끝없이 반복된다.
그래서 신경망이 배우는 건 동작이라기보다 습관이다. 운전을 배우는 것과 비슷하다. 쇠공에 맞았을 때 휘청하는 것도, 블록 모서리에서 발을 고쳐 딛는 것도 누가 넣어 준 게 아니라 이 반복 속에서 저절로 나온다. 학습은 이 습관을 수많은 가상 세계에서 동시에 연습시키는 일이다.
어떤 순서로 만들었나
결과보다는 방향이 바뀐 순간 위주로 적으면 대략 이렇다.
- 학습도 MuJoCo, 브라우저도 MuJoCo 공식 WebAssembly 빌드로 가기로 정했다. 같은 물리를 양쪽에서 돌려야 학습한 걸음이 화면에서도 똑같이 나온다.
- 처음에는 엉뚱한 데 힘을 썼다. 이 얘기는 아래에서 따로 한다.
- 몸체를 새로 만들었고, 처음으로 학습한 정책이 평지를 걸었다.
- 판단 기준을 "화면에 보이는 품질"로 바꾸고 블록 지형으로 넘어갔다. 여기서부터 진도가 확 붙었다.
- 블록 모서리에서 발이 바닥에 살짝 파묻히는 게 눈에 보여서, 물리 계산을 1초에 480번까지 올렸다.
- 강화학습으로 배운 정책이 브라우저에서 실제 속도로 블록 지형을 건넜다.
- 소개 영상을 찍었다. 위에 붙인 그 영상이다.
- 데모를 공개했다. 그 뒤로는 장애물 앞에서 갇히는 문제를 잡는 학습을 이어서 돌렸다.
- 학습 중에 물리가 가끔 터지는 원인을 찾았고, 첫 로딩을 줄이고 CDN을 붙였다.
하면서 배운 것
직접 해 보고 확인한 것 위주로 적는다.
보상 점수 말고 영상을 믿는다
보상은 몇 갈래면 된다. 목표 속도를 잘 따라가는지, 똑바로 서 있는지, 가려는 쪽을 보고 있는지, 힘을 쓸데없이 쓰지 않는지, 발 말고 다른 곳이 땅에 닿지 않는지. Embark도 이런 성격의 항목을 열 개 남짓 섞어 썼다고 했다.
문제는 점수가 오른다고 걸음이 좋아진다는 보장이 없다는 거다. 점수는 그럴듯한데 발을 질질 끌거나, 다리 하나를 놀리거나, 둥둥 떠다니듯 걷는 정책이 정말 자주 나온다. 그래서 후보가 나올 때마다 실제 속도로 녹화해서 눈으로 봤다. 보상을 이리저리 만지는 일은 끝이 없다. 가설 하나에 몇 번까지 해 볼지 미리 정해 두고, 안 되면 미련 없이 다른 원인을 찾았다.
걸음의 절반은 물리 설정이 만든다
관절이 얼마나 단단한지, 얼마나 빨리 멈추는지, 접촉을 어떻게 계산하는지, 물리를 얼마나 잘게 쪼개서 계산하는지. 이런 값들이 걸음의 인상을 확 바꾼다. 같은 신경망을 넣어도 설정이 다르면 다른 로봇처럼 보인다. Embark도 모터 강성과 감쇠를 몇 년 동안 만졌다고 했으니, 나만 겪는 일은 아니었던 셈이다.
내 경우엔 블록 모서리에서 발이 바닥을 살짝 파고드는 게 보였다. 처음엔 충돌 모양을 정교하게 다듬으면 해결될 줄 알았는데 아니었다. 충돌 모양은 오히려 단순하게 두고 계산 간격을 줄이는 쪽이 맞았다. 대신 물리를 바꿀 때마다 기존 정책과 검증 결과는 버리고 다시 학습하고 다시 쟀다. 물리가 바뀌면 더 이상 같은 로봇이 아니다.
사고는 섞어서 가르치고, 시험은 따로 본다
학습할 때는 지형을 매번 바꾸고, 출발 자리와 방향을 흔들고, 걷는 도중에 밀고, 길에 상자를 놓았다. 한 가지 상황에만 익숙해지지 않게 하려는 거다. 상자를 발밑 지형처럼 볼 수 있게 해 주고 이렇게 섞어서 가르쳤더니, 장애물이 있을 때 갇히는 비율이 40% 안팎에서 10% 안팎으로 떨어졌다.
평가는 학습에 한 번도 쓰지 않은 지형에서, 다른 난수로 다시 한다. 그리고 갇힘 0%는 목표로 삼지 않는다. 물리적으로 도저히 못 지나가는 배치도 있고, 숫자 하나만 보고 달리다 보면 그 시험만 잘 보는 정책이 나온다. 개선 폭이 시험할 때마다 생기는 오차와 비슷해지면 거기서 멈춘다.
눈은 단순하게 시작한다
로봇은 발밑을 높이 지도로 본다. 위에서 아래로 광선을 쏴서 지형 높이를 재는 방식이다. Embark도 몇 년 동안 이렇게 했고, 터널이나 다리 밑처럼 위가 막힌 곳에서 문제가 생겨서 나중에 로봇 몸에서 광선을 쏘는 방식으로 바꿨다고 했다. 탁 트인 블록 지형만 걷는다면 높이 지도로 충분했다. 필요해지기 전에는 눈을 복잡하게 만들지 않았다.
세 군데의 물리를 맞춰야 한다
학습은 빠른 물리 위에서 여러 세계를 동시에 돌려서 한다. 그런데 같은 로봇이 사실은 세 군데에서 돈다. 빠르게 학습시키는 물리, 채택하기 전에 꼼꼼히 검사하는 더 정밀한 물리, 그리고 실제로 보여 주는 브라우저. 이 셋이 같은 답을 내지 않으면 학습에서 잘 걷던 로봇이 화면에서는 비틀거린다. 그래서 후보는 정밀한 검사를 통과해야 했고, 브라우저 실행은 검사용 시뮬레이션과 한 단계씩 맞대어 보고 사실상 같은 결과가 나오는 걸 확인한 뒤에야 올렸다.
학습 쪽은 가끔 물리가 터졌다. 숫자가 갑자기 망가지는 거다. 터지기 직전 상태를 붙잡아서 더 정밀한 계산으로 다시 돌려 보니 멀쩡했다. 범인은 마찰을 아주 빡빡하게 계산하게 해 둔 설정이었는데, 학습용의 빠르지만 덜 정밀한 계산과 궁합이 안 맞았다. 게다가 이렇게 터져서 끝난 판을 학습이 어떻게 받아들이느냐에 따라, 잘 되던 학습이 통째로 무너지기도 했다. 빠른 물리에는 이런 함정이 숨어 있다. 다른 물리로 다시 돌려 보는 습관이 원인을 찾는 가장 빠른 길이었다.
기준은 먼저 정하고, 나중에 바꾸지 않는다
학습을 돌리기 전에 가설, 바꿀 것, 예산, 합격 기준을 먼저 적어 뒀다. 끝나면 결과든 실패든 그대로 남겼다. 그렇게 쌓인 연구노트가 440개를 넘는다.
가장 최근에 돌린 학습은 갇힘을 한쪽 시험에서 9.8%, 다른 쪽에서 20% 줄였는데, 기준이 "둘 다 10% 넘게"였기 때문에 채택하지 않았다. 0.2%p 차이라 솔직히 아까웠다. 그래도 결과를 보고 기준을 고치기 시작하면 그다음부터는 어떤 숫자도 믿을 수 없게 된다.
브라우저에서 돌아가야 끝난 거다
학습이 끝나도 사람이 볼 수 없으면 소용이 없다. 브라우저 안에서 물리 엔진(WebAssembly), 신경망(ONNX Runtime Web), 그래픽(three.js)을 같이 돌리면서 실제 속도를 지키는 게 목표였다. 기기가 느리면 장면을 건너뛰지 않고 그냥 느리게 돌린다. 건너뛰면 물리가 달라지기 때문이다.
마지막으로 손본 건 첫 로딩이다. 안 쓰는 큰 파일을 걷어 내서 처음 받는 양을 16.6MB에서 11.6MB로 줄이고, 파일을 처음부터 한꺼번에 받게 바꾸고, CDN을 붙였다. 잴 때마다 5초에서 26초까지 들쭉날쭉하던 첫 방문이 3초 안팎으로 줄었다. 다시 들어오면 1~2초면 뜬다.
잘 안 된 것
제일 아픈 건 초반을 눈에 보이지도 않는 정밀도에 썼다는 거다. 아주 작은 접촉 오차까지 증명하겠다고 붙들고 있다가, 정작 걷는 정책은 한참 늦게 나왔다. 기준을 "화면에 보이는 품질"로 바꾸고 나서야 속도가 붙었다. 가장 비싸게 배운 교훈이다.
로봇은 아직도 가끔 지형의 움푹한 곳에 갇힌다. 데모에서는 6초 동안 0.3m도 못 가면 방향을 틀어 주고, 그래도 안 되면 근처 물체를 치우거나 학습 때 겪었던 정도의 약한 힘으로 살짝 밀어 준다. 이럴 땐 화면에 도와주는 중이라고 띄운다. 스스로 빠져나오는 정책은 아직 학습 중이다.
걸음도 아주 자연스럽지는 않다. Embark는 애니메이터가 만든 동작을 본보기로 삼아 걸음 스타일을 가르쳤다고 했다(AMP). 나는 본보기로 쓸 동작이 없어서, 험한 지형을 잘 걷는 쪽을 먼저 골랐다.
그리고 위가 막힌 곳은 못 본다. 높이 지도의 한계다. 터널을 걸어야 할 날이 오면 눈부터 바꿔야 한다.
직접 해 보기
데모 주소는 여기다. https://www.coolspeed.org/gold-spider/
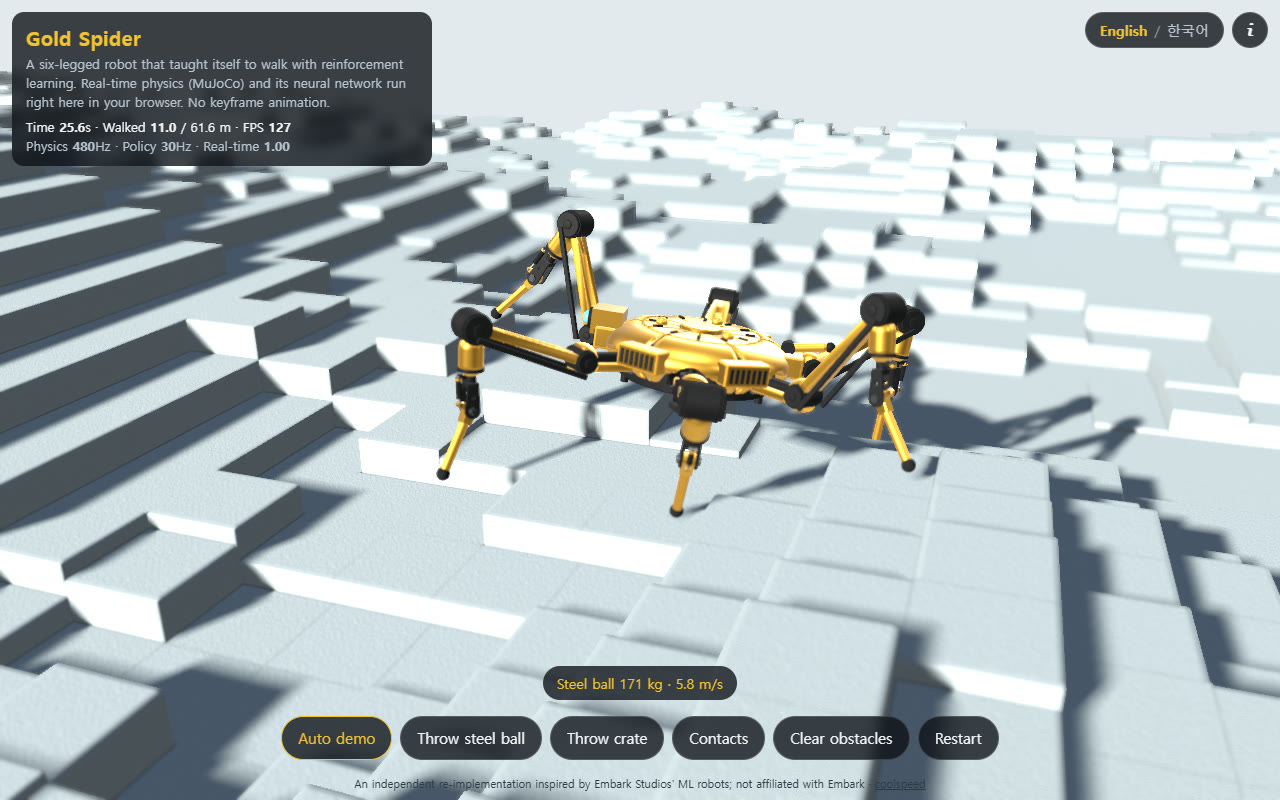
해 볼 만한 것 몇 가지.
- Throw steel ball을 누르면 171kg 쇠공이 날아간다.
- Contacts를 켜면 발이 땅에 닿는 자리가 빨간 점으로 보인다.
- Auto demo를 끄고 길에 상자를 쌓아 보자. 돌아서 가는지, 갇히는지.
- 오른쪽 위에서 한국어로 바꿀 수 있다.
WebAssembly와 WebGL이 되는 최신 브라우저면 되고, 휴대폰에서도 열린다.
마치며
Embark가 몇 년에 걸쳐 풀어 놓은 이야기를 혼자 따라가 보니, 반짝이는 아이디어보다 지루한 일이 훨씬 많았다. 물리 설정을 맞추고, 실험을 적고, 세 군데의 물리가 같은 답을 내게 만들고, 브라우저에서 빨리 뜨게 하는 일들이다. 그래도 공에 맞은 로봇이 휘청하다가 다시 제 갈 길을 가는 걸 볼 때마다 아직도 웃음이 난다.
Embark Studios의 ML 로봇에서 영감을 받아 따로 만들어 본 것이고, Embark와는 관계가 없다. 참고한 공개 자료는 Embark의 2021년 글 「Transforming animation with machine learning」과 NDC26 발표 「Machine Learning Implementation – The Case of Embark Games」(Martin Singh-Blom)다.